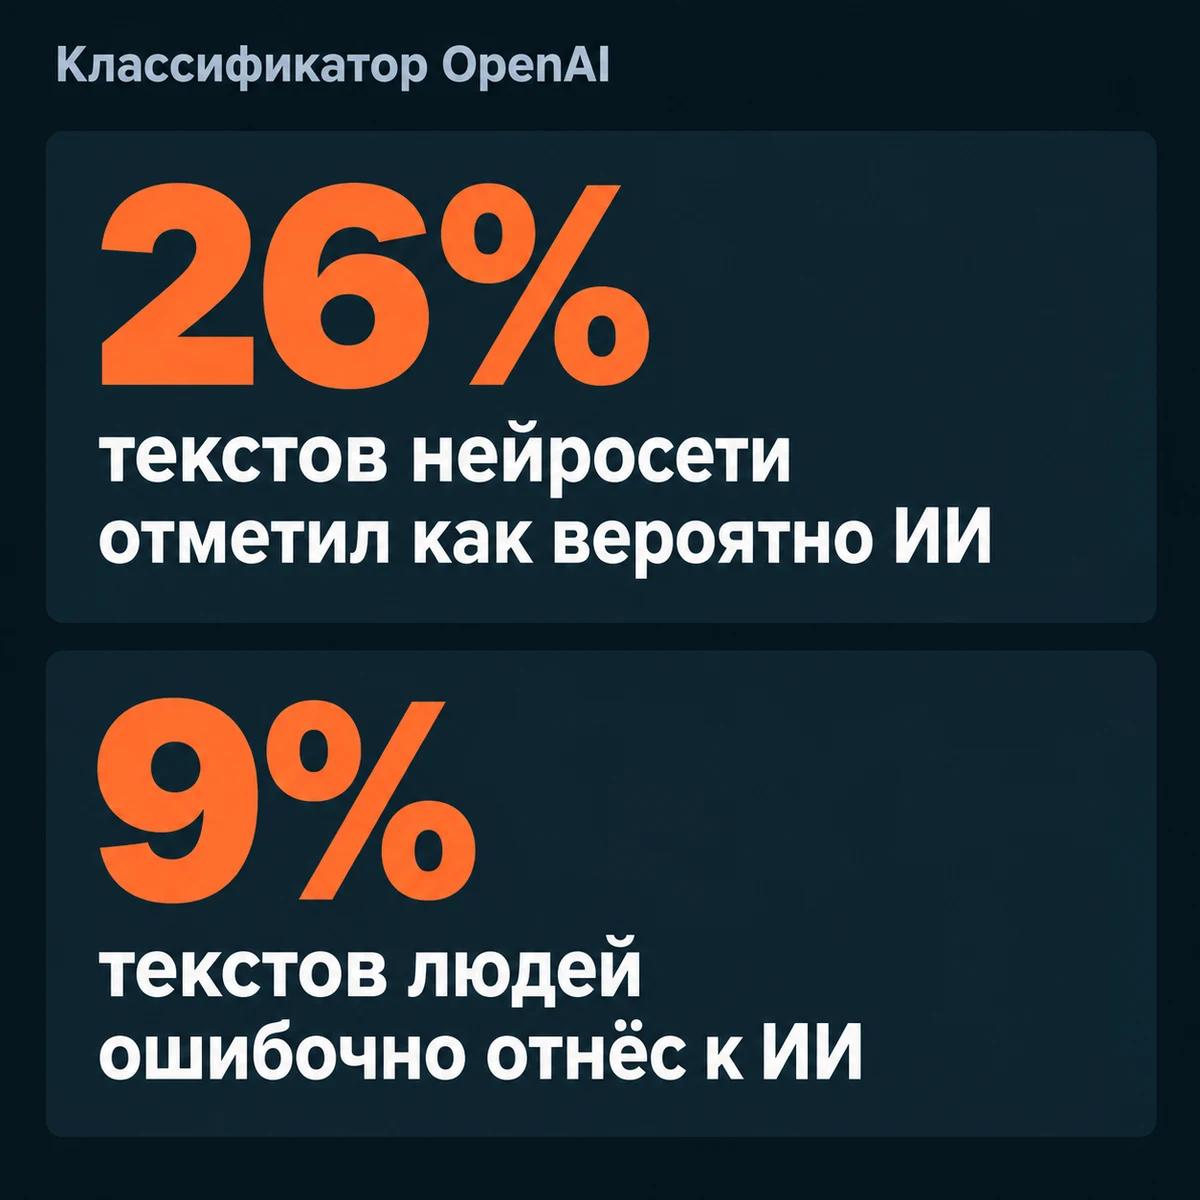
Два сервиса проверки текста на ИИ, GPTZero и ZeroGPT, в 2023 году решили, что отрывок Конституции США написала нейросеть. А Конституцию подписали в 1787 году. Детектор выдаёт вероятность, а не доказательство, и ошибается в обе стороны. Собственный классификатор OpenAI, разработчика ChatGPT, помечал как вероятно написанные ИИ лишь 26% текстов нейросети, а тексты людей ошибочно относил к ним в 9% случаев. В июле 2023 года компания закрыла его, сославшись на низкую точность.
Для того, кто принимает тексты от авторов и подрядчиков, это меняет сам вопрос. Важно не то, писала ли текст нейросеть, а можно ли за него поручиться - верны ли факты и полезен ли текст читателю. Высокий процент детектора - повод проверить внимательнее, но не основание вернуть текст или обвинить автора.
Почему Конституция похожа на текст нейросети
Среди признаков, на которые чаще всего смотрят детекторы, сам GPTZero называет предсказуемость текста и разнообразие предложений по длине и строю. Чем меньше текст «удивляет» языковую модель, тем охотнее детектор относит его к машинным. Создатель GPTZero Эдвард Тиан объяснял изданию Ars Technica, что Конституцию много раз включали в обучающие данные больших языковых моделей. Модели научились писать похоже, и детектор принял знакомый текст за их работу.
Предсказуемо пишут и люди, особенно в формальном стиле законов и некоторых научных текстов, - на это указывает та же Ars Technica. В 2023 году исследователи Стэнфорда проверили семь популярных детекторов на эссе для экзамена по английскому, которые писали иностранцы. В среднем детекторы приняли за тексты ИИ 61% эссе, а сочинения американских восьмиклассников распознали почти без ошибок. Авторы связывают разницу с более простой и однообразной лексикой иностранцев. Поэтому под подозрение может попасть и автор-человек, который пишет однотипные тексты по строгому шаблону, например описания товаров.
Что изменилось к 2025 году
В 2025 году исследователи Чикагского университета сравнили три коммерческих детектора и одну открытую модель. Они взяли около 2000 текстов людей шести жанров, от блогов и отзывов до резюме, и версии тех же текстов от четырёх нейросетей. Коммерческие детекторы ложно отметили меньше 1% человеческих текстов - у классификатора OpenAI на его собственной проверке было 9%.
Но сервисы оказались очень разными. Один из коммерческих детекторов пропускал от 10 до 40% текстов нейросети в зависимости от того, какая из четырёх их писала. Открытая модель во многих случаях угадывала не лучше подброшенной монетки. Насколько точен сервис, которым пользуетесь вы, по такому сравнению не узнать, ведь в нём всего четыре инструмента. Сами авторы предупреждают, что разрешённое использование ИИ, например правку грамматики, трудно отделить от остального.
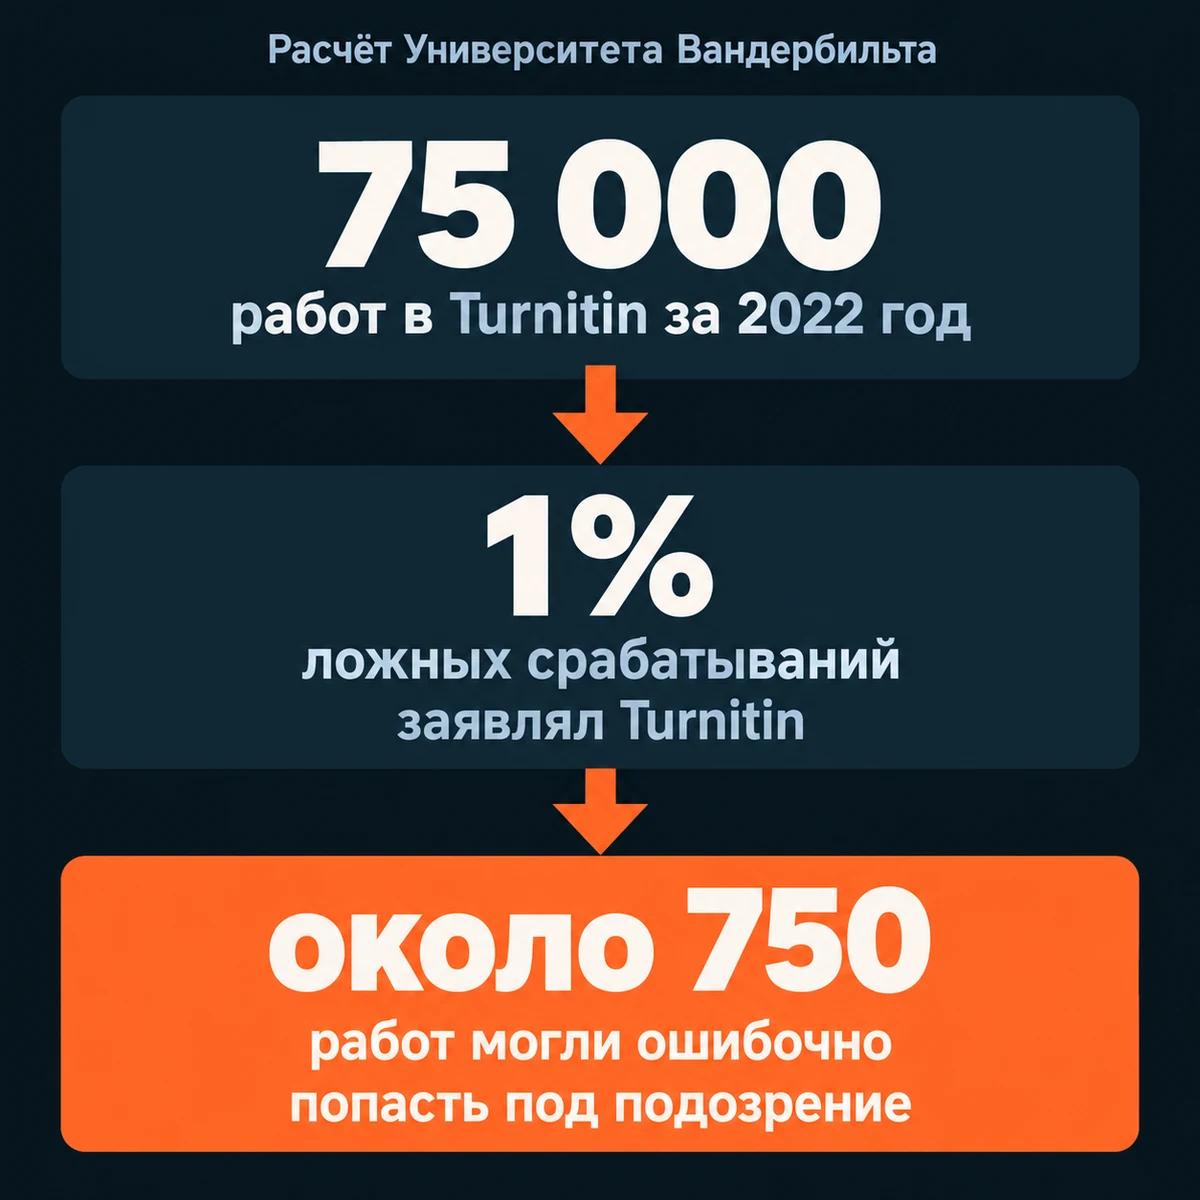
Даже 1% ошибок на большом потоке задевает живых людей. Turnitin, сервис для проверки студенческих работ, при запуске своего детектора ИИ заявлял как раз такую долю ложных срабатываний. Университет Вандербильта посчитал, что из 75 000 работ, которые он отправил в Turnitin в 2022 году, под подозрение ошибочно попали бы около 750, и в августе 2023 года отключил детектор. Ещё одной проблемой университет назвал то, что Turnitin не объяснял, по каким признакам решает, что текст написал ИИ.
Как принимать текст подрядчика без спора о процентах
Для поисковых систем способ создания текста вторичен. Google в феврале 2023 года написал, что качество контента для него «гораздо важнее того, каким способом он создан». Яндекс в марте 2025 года - что «само по себе использование нейросетей не является негативным фактором», если текст качественный, проверен экспертом, не вводит в заблуждение и помогает решить вопрос. Поэтому текст принимают по тому, что можно проверить и показать автору.
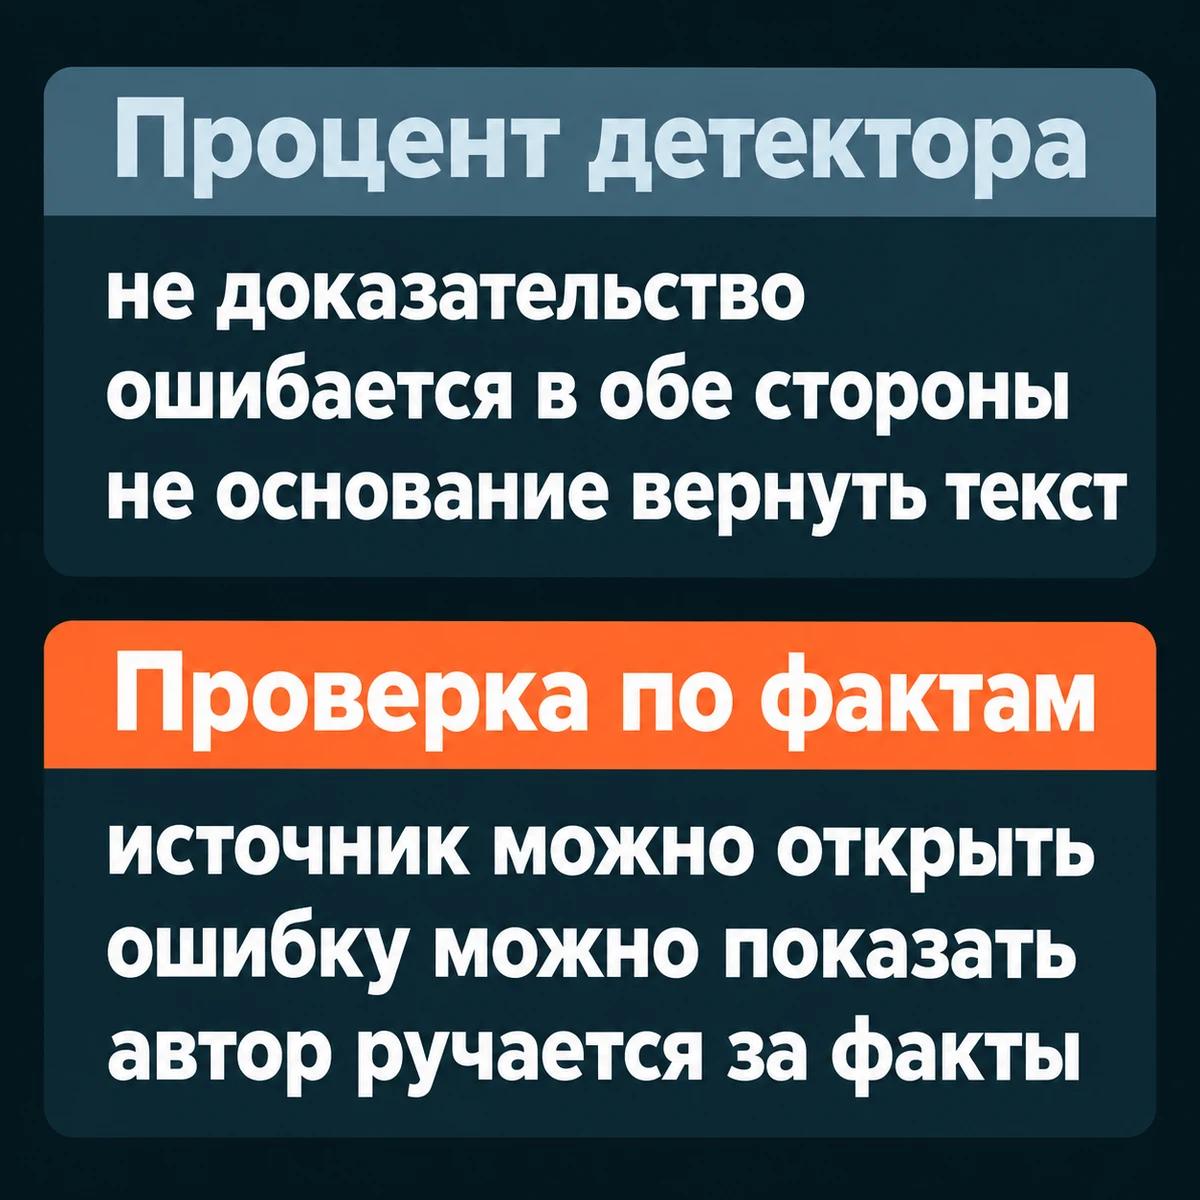
- Откройте источник каждого числа, цитаты и ссылки. Нейросеть способна сочинить источник целиком, как это было с судебной практикой, которую она придумала для юристов. Выдуманный источник, в отличие от процента, можно показать автору.
- Попросите автора поручиться за каждый факт и объяснить, откуда он взят. Именно такой вопрос вместо детектора предлагала Ars Technica. Если автор пользовался нейросетью, но проверил и может объяснить каждое утверждение, такой текст можно принимать. Резкая смена стиля и уровня по сравнению с прошлыми текстами автора - повод поговорить с ним.
- Проверьте пользу. Текст должен отвечать на вопрос, ради которого его заказывали, и содержать то, что знает только ваша компания, - цифры, примеры, условия. Гладкий текст без таких деталей слаб независимо от того, кто его писал, и детектор этого не покажет.
- Договоритесь о правилах заранее. В задании или договоре укажите, можно ли пользоваться нейросетью, нужно ли об этом сообщать и кто отвечает за факты. Университет Вандербильта советовал преподавателям то же - заранее объяснять, что разрешено, а разрешённое использование ИИ просить раскрывать. Решить, что разрешать, поможет разбор задач, которые уже отдают нейросетям.
- Не вставляйте неопубликованный текст с данными клиентов и цифрами компании в незнакомый онлайн-детектор. Тот же университет не стал переходить на сторонние детекторы в том числе потому, что неизвестно, как они хранят и используют загруженные тексты. Здесь действует общее правило о том, что можно передавать внешним сервисам.
Этот список нужен при любом проценте: детекторы пропускают тексты нейросетей, а в фактах ошибаются и люди.
Если статьи для сайта нужны регулярно, такую приёмку встраивают в сам выпуск. Так устроен и этот журнал. Его выпускает автоматическая редакция Kvema, а итоговую версию статьи принимает отдельный ИИ-редактор, который её не писал и не правил, - по источникам и сохранности смысла. Как устроен выпуск статей для бренда.
Откуда автоматическая редакция берёт темы и что отсеивает, прежде чем писать, рассказывает первая часть «Журнала на нейросетях».
Источники
- Ars Technica: почему детекторы ошибаются на Конституции США, 14.07.2023, и о закрытии классификатора OpenAI, 26.07.2023
- Текст Конституции США, Национальный архив США
- GPTZero о признаках, на которые смотрят детекторы, раздел вопросов, 30.10.2026
- Исследование Стэнфорда о детекторах и эссе иностранцев, 2023
- Рабочая статья Чикагского университета, сентябрь 2025, и её разбор в журнале школы бизнеса, 02.12.2025
- Университет Вандербильта об отключении детектора Turnitin, 16.08.2023
- Google о контенте, созданном с помощью ИИ, 08.02.2023
- Яндекс об обновлении алгоритмов поиска, 28.03.2025