Темы для этого журнала готовит нейросеть-планировщик автоматической редакции Kvema. Берутся они из трёх мест: из семантического ядра, то есть запросов, которые люди вводят в Яндексе, из плана редакции с сериями и историями компаний и из экспериментов с форматом. Почти все правила планировщика - о том, какую тему не брать. Отсеивается тема, которая ничего не даст подготовленному читателю, не касается работы, перекосит план или повторяет уже написанное.
Это первая часть серии о том, как устроен журнал на нейросетях, и её главный вопрос - почему частый запрос ещё не тема. Если брать запросы ядра сверху вниз, журнал о нейросетях превращается в журнал о CRM, ЭДО и RPA. С первой пачкой тем, собранной 18 октября 2026 года, так и вышло - 60% тем попали в рубрику «Автоматизация» и ни одна в «Нейросети».
Откуда приходят темы
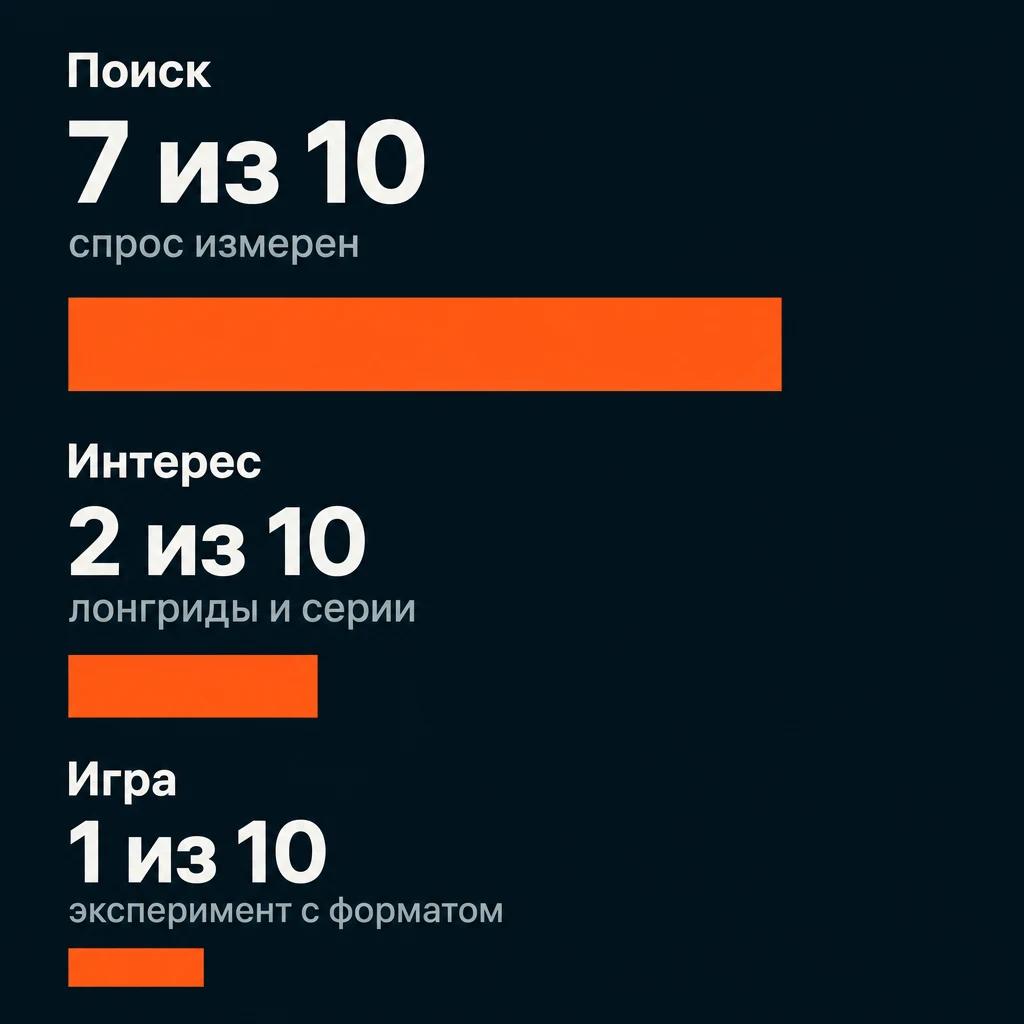
План журнала поделён на три доли. Семь тем из десяти относятся к «поиску», и спрос на них измерен. Такую тему берут из семантического ядра, где запросы с частотой в месяц разложены на кластеры по смыслу, или из вопроса людей, у которого есть источник. Например, по архиву Букварикса 2025 года для Яндекса в России запрос «ии для бизнеса» вводят около 2 тысяч раз в месяц, и этот ключ стоит в заголовке статьи о пяти задачах, которые уже отдают нейросетям.
Две темы из десяти - «интерес». Это лонгриды и серии, которые читают и пересылают, - истории компаний, антикейсы и «Мастерская», где выходит эта статья. Ещё одна тема из десяти - «игра», эксперимент с форматом вроде краш-теста или проверки мифа.
У каждой темы планировщик помечает, что известно о спросе. Это может быть число с источником, датой и регионом, косвенный признак вроде одного и того же вопроса в поддержке или ничего. Эта статья - как раз третий случай. Запроса о том, как устроен журнал на нейросетях, в ядре нет, и в карточке темы так и записано - спрос не измерен. Брать такую тему можно, но нельзя выдавать её приоритет за измеренный.
С 27 октября 2026 года журнал раз в неделю разбирает и тренды. Это публикации о нейросетях и автоматизации на Хабре и других русских и зарубежных площадках, набравшие в разы больше обычного для своего источника. Из них журнал берёт только подачу - с чего начать статью и как построить заголовок, - а факты из чужих постов попадают в статью лишь через проверенные источники.
Приведёт ли тема к заявке
Частота показывает, сколько людей может прийти, но не говорит, нужен ли им продукт компании. Для этого у темы есть балл от 0 до 3. Шкалу придумал Тим Соуло, директор по маркетингу Ahrefs. В 2024 году он писал, что в Ahrefs ею пользуются почти десять лет и в контент-маркетинге компании это главная метрика. К каждой теме Соуло предлагает один вопрос - получится ли убедить читателя этой статьи купить продукт.
Журнал переложил шкалу на услуги Kvema и ставит балл по конкретной услуге. Слова «автоматизация» или «документы» в названии темы его не поднимают.
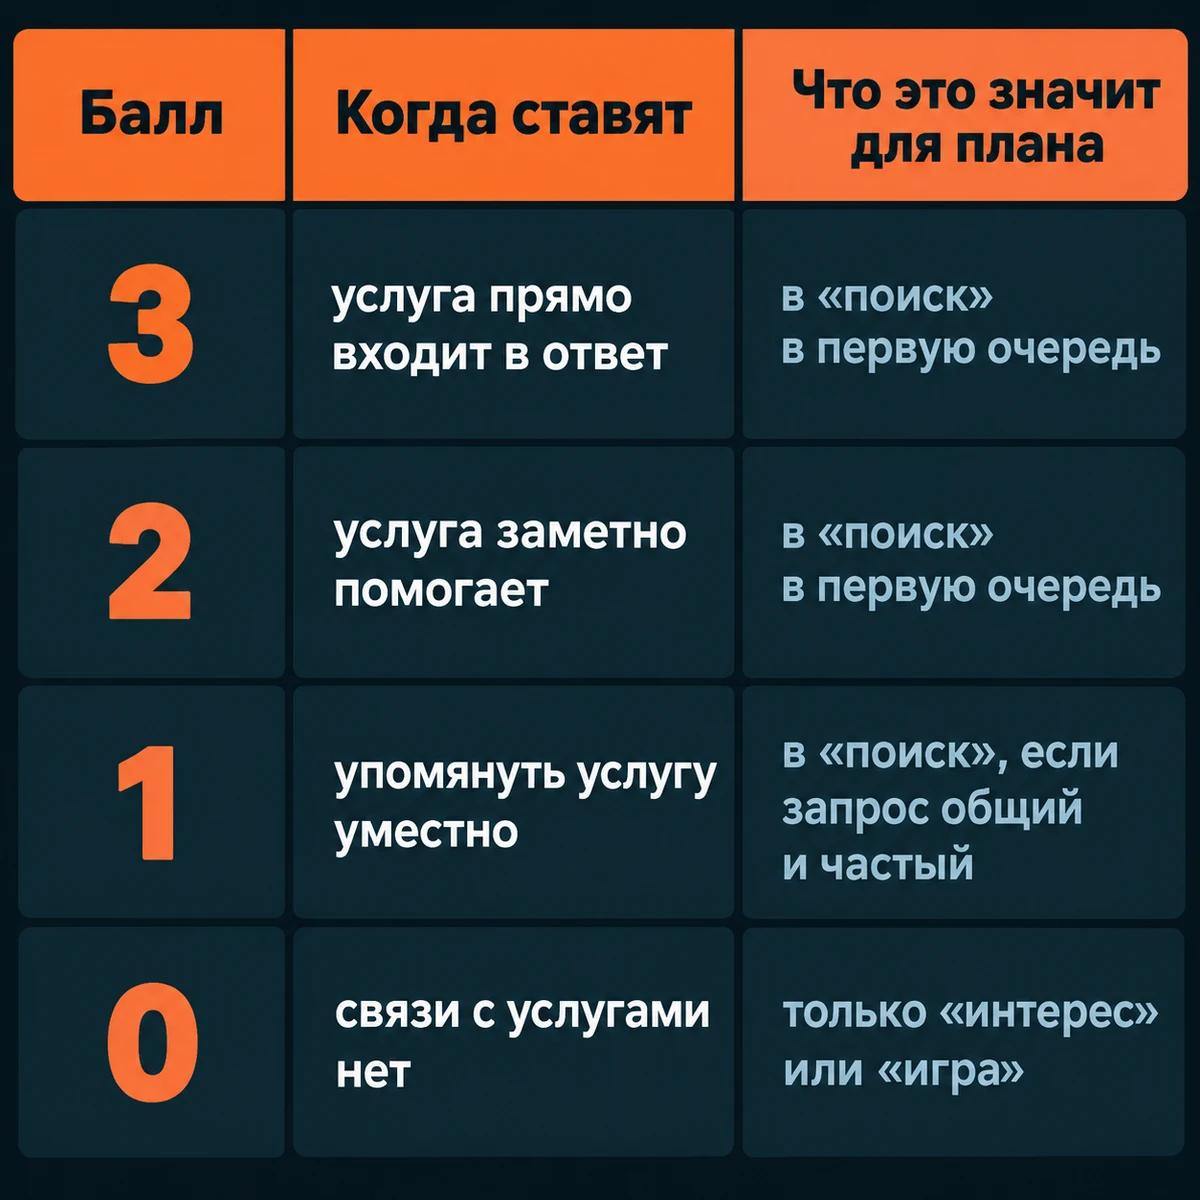
| Балл | Когда ставят | Что это значит для плана |
|---|---|---|
| 3 | услуга прямо входит в ответ | в «поиск» в первую очередь |
| 2 | услуга заметно помогает | в «поиск» в первую очередь |
| 1 | упомянуть услугу уместно | в «поиск», если запрос общий и частый |
| 0 | связи с услугами нет | только «интерес» или «игра» |
Соуло советует держаться тем с баллом 2-3 и спускаться ниже, только когда они закончились. У журнала правило мягче. Кроме заявок, ему нужны читатели из поиска и показ того, как работает автоматическая редакция, поэтому в плане две нижние границы.
Среди тем «поиска» не меньше трети - с баллом 2-3, иначе журнал соберёт трафик без заявок. И из каждых десяти тем «поиска» не меньше трёх - из самых частых кластеров ядра, чтобы журнал не уходил в безопасные редкие темы. Границы тянут в разные стороны.
Что отсеивается до очереди
С 23 октября 2026 года первым проверяют уровень читателя. Планировщик называет, что читатель уже знает, что его ещё затрудняет и что он сможет выбрать, сделать или проверить после статьи. Бухгалтеру, который каждый день подписывает документы в ЭДО, ликбез «что такое ЭДО» ничего не даст, как бы часто такой запрос ни вводили.
Тогда же из банка тем сняли базовые формулировки про CRM, цифровизацию и RPA. Тему про RPA оставили, но развернули к выбору, который у читателя действительно есть, - RPA или ИИ-агент для переноса данных между системами.
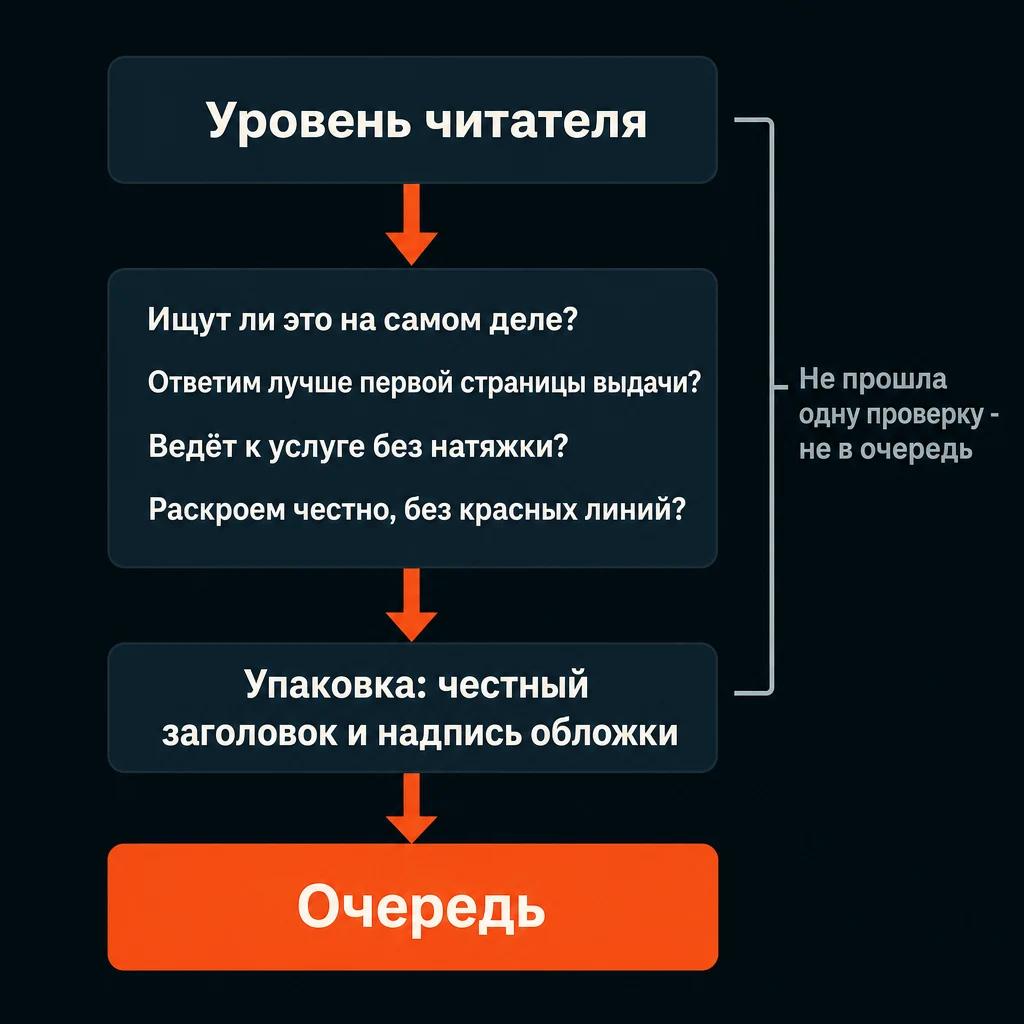
После уровня читателя планировщик проверяет, ищут ли это на самом деле, сможет ли журнал ответить заметно лучше первой страницы выдачи, ведёт ли тема к услуге без натяжки и можно ли раскрыть её честно, не переходя красных линий. Одного «нет» хватает, чтобы тема не попала в очередь.
Темы не о работе не берут даже при большом спросе - например, развлечения или учебные задания «за студента». Покупательский запрос тоже не тема - по словам «купить», «скачать» или «вход» в выдаче стоят магазины и сами сервисы.
Последний фильтр - упаковка. Если из пяти-десяти заголовков по разным формулам не складывается честный заголовок с надписью для обложки, тема считается сырой и в очередь не идёт.
Как ловят повторы
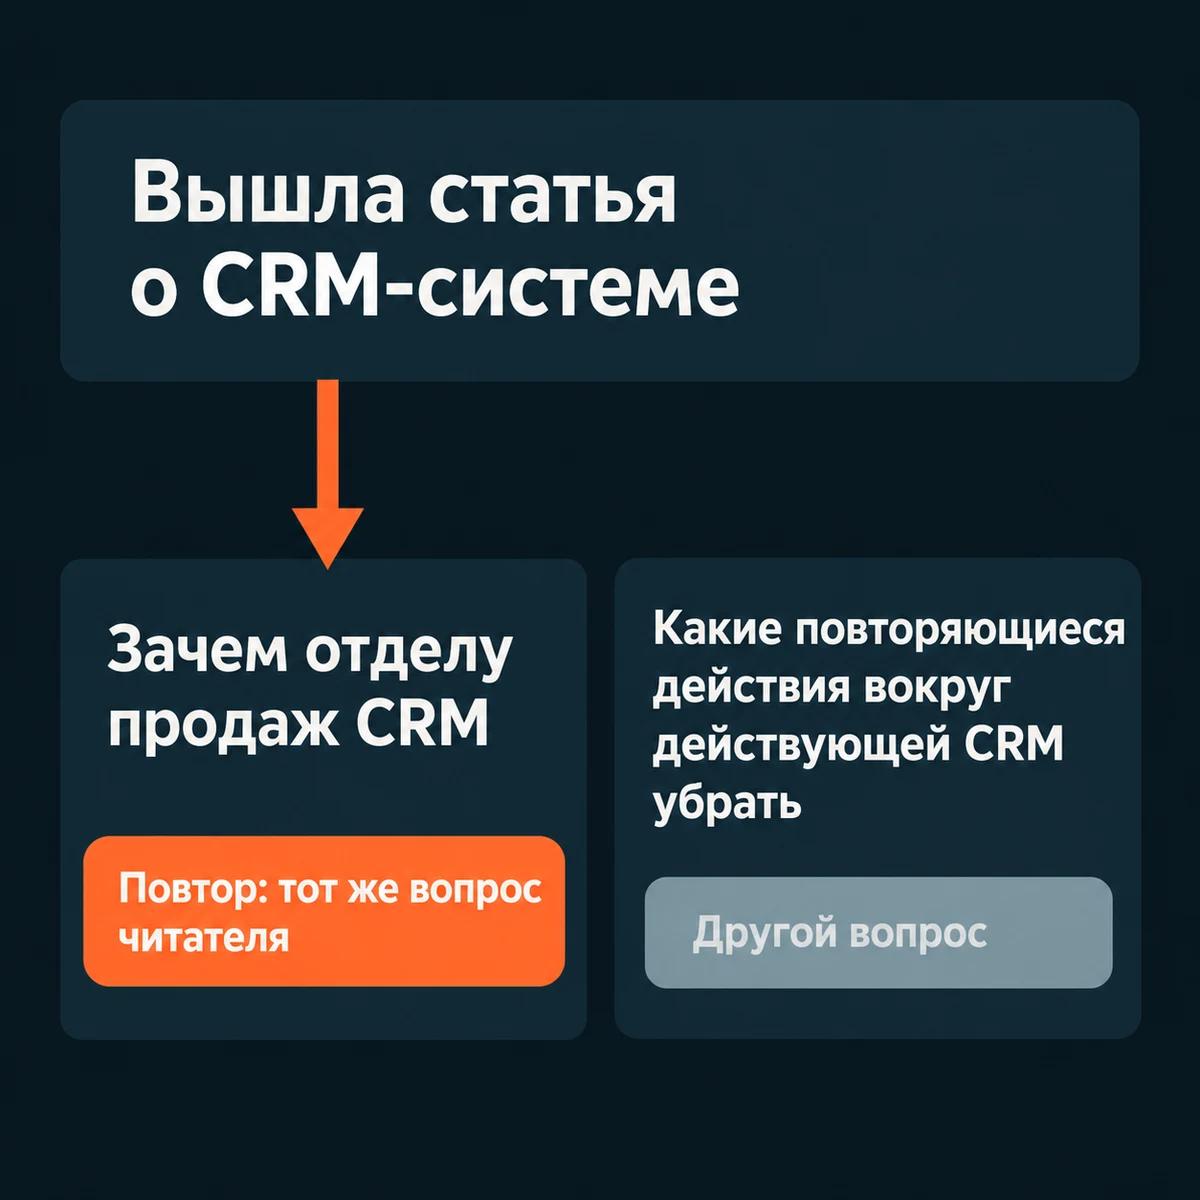
Дублем считают тему, которая отвечает на тот же вопрос читателя, что и вышедшая статья, даже если слова в заголовке другие. Сверяют со всем, что уже вышло, и со всеми темами очереди, включая отложенные. Например, тема «Зачем отделу продаж CRM» повторила бы вопрос статьи о CRM-системе, хотя заголовки у них разные. А «какие повторяющиеся действия вокруг действующей CRM убрать» - уже другой вопрос.
Перед тем как писать статью, тему ещё раз проверяют на повтор. Программа ищет похожие статьи по словам темы, а нейросеть-автор сверяет вопрос по смыслу с вышедшими статьями и черновиками. Если у новой статьи не находится своего угла, её не пишут, а людям показывают объяснение, что уже раскрыто в похожей статье и что лучше сделать вместо новой.
Где сложнее всего
Главная трудность - равновесие между спросом и предметом журнала. Верх ядра почти целиком относится к рубрике «Автоматизация», поэтому доли рубрик стоят выше порядка ядра. Сначала планировщик выбирает рубрику, которой не хватает до своей доли, - у «Нейросетей» это около 35% тем, - и только потом берёт её самый частый свободный кластер. Если верхние кластеры рубрики не проходят проверку уровня читателя, их пропускают с названной причиной, а долю не добирают неподходящими темами.
Ни одна из этих проверок не скажет, захочет ли человек открыть статью. По правилам планировщика список тем до постановки в очередь показывают двум-трём людям из аудитории и спрашивают, что из этого они бы открыли. Молчание и вежливое «интересно» считаются отказом. Если показать некому, пропуск записывают в итог планирования, чтобы он не выглядел пройденной проверкой.
После выхода тему оценивают по просмотрам из поиска. Остальные просмотры зависят от того, где статья стоит на странице журнала, - что выше, то и открывают. Выводы делают только по статьям старше 21 дня, набравшим не меньше 30 просмотров, а раньше цифры - шум.
За один заход планировщик доводит не больше пяти тем. Автопилот берёт темы из очереди подряд и не переспрашивает, поэтому двадцать сырых гипотез хуже пяти готовых тем. Если готовых меньше, недобор называют числом и слабыми темами не добивают.
Самое трудоёмкое в таком отборе - не придумать темы, а записать правила под свой продукт и читателя, иначе планировщику остаётся одна частота. Kvema настраивает такой выпуск статей для компаний на той же основе, что у этого журнала, - темы связывают с предложением компании, а проверки и публикацию настраивают на её сайте.
Как собрать такой отбор у себя
Повторить этот порядок можно и без нейросети, в обычной таблице тем.
- Соберите запросы своей темы с частотой в месяц и разложите их на кластеры по смыслу - это и будет ядро.
- Запишите, что ваш читатель уже знает, и до того, как смотреть на частоту, отсеивайте темы, которые ничего нового ему не дадут.
- Поставьте каждой теме балл от 0 до 3 по вопросу Соуло.
- Задайте доли целей и две нижние границы - по заявкам и по спросу.
- Сверяйте новую тему со всем вышедшим и запланированным по вопросу читателя, а не по словам.
В следующей части - как нейросети пишут и проверяют статью по теме из очереди.
Источники
- Тим Соуло о бизнес-потенциале темы, 14.08.2024
- Курс Ahrefs о блоге для бизнеса, открыт 28.10.2026