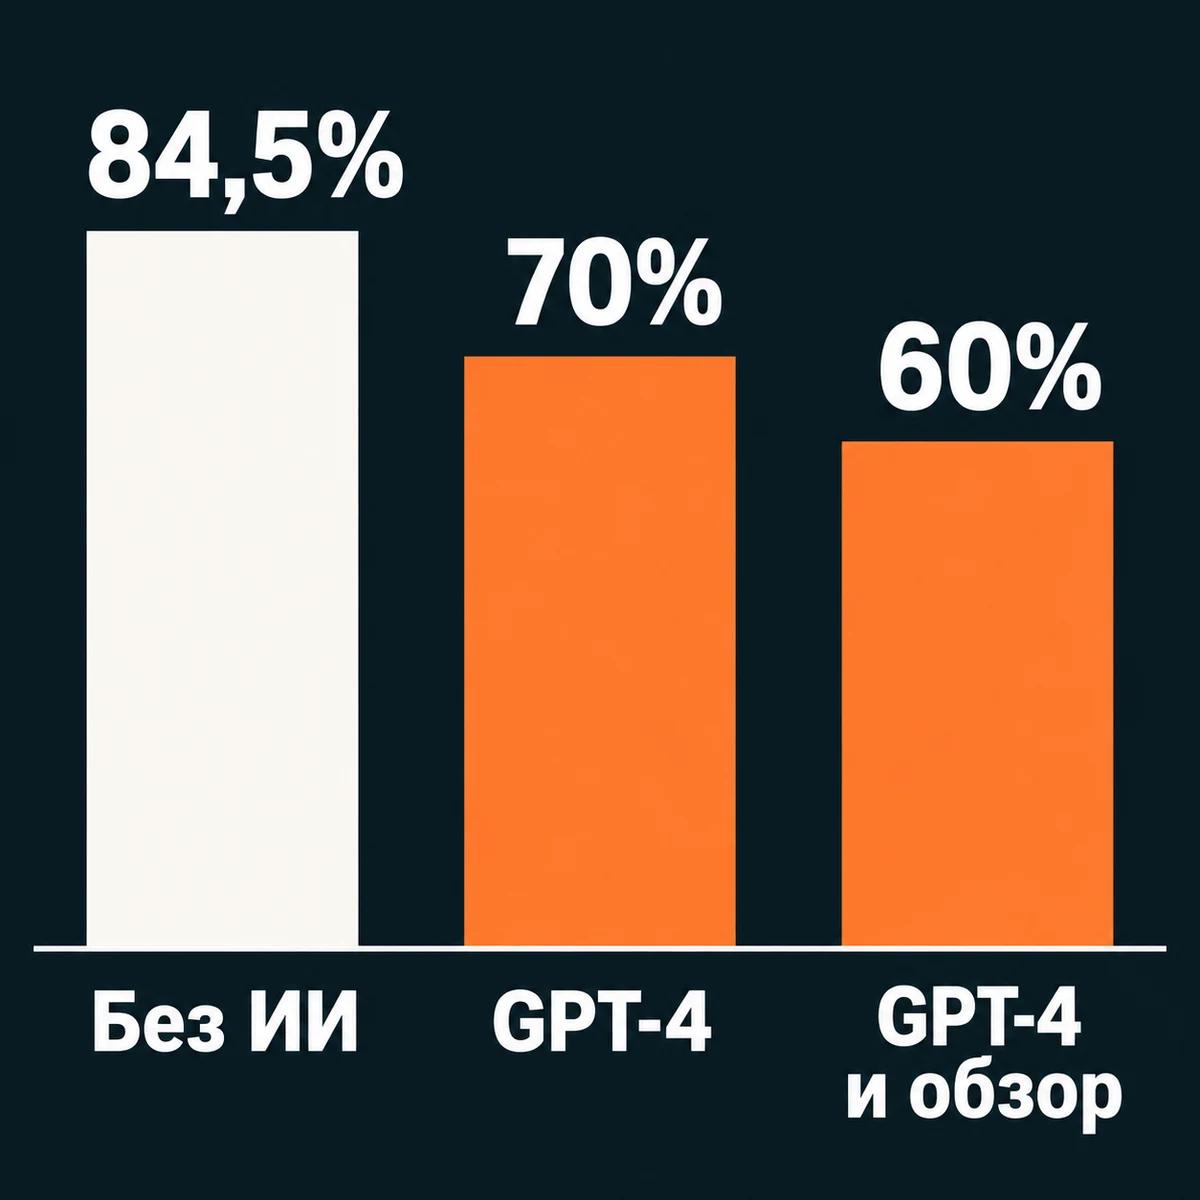
Консультанты BCG, которым дали GPT-4, чаще ошибались на задаче, которую модель сама решала неверно. Без ИИ её верно решили 84,5% участников, с ИИ - 60 и 70% в двух группах. А в другом эксперименте того же исследования на задачах, посильных модели, консультанты с ИИ сделали на 12,2% больше задач и работали на четверть быстрее.
Что модель иногда ошибается, знает каждый, кто давал ей рабочие задачи. Эксперимент показывает, почему этого мало, чтобы решить, на каких задачах ей доверять. Авторы называют картину неровной границей возможностей ИИ - задачи похожей сложности оказываются по разные её стороны, и снаружи этого не видно, даже по тому, как написан ответ. Поэтому, прежде чем дать ИИ всему отделу, модель проверяют на своих задачах, верный ответ по которым уже известен.
Что делали 758 консультантов
Эксперимент провели весной 2023 года исследователи Гарвардской школы бизнеса и ещё трёх университетов вместе с BCG. Компания предложила консультантам по всему миру потратить на него пять часов, и до конца дошли 758 человек - около 7% рядовых консультантов BCG. Чтобы участники старались, добросовестное участие засчитывали как вклад в работу офиса, а это влияло на годовую премию. В 2026 году исследование напечатал научный журнал Organization Science.
Участников развели по двум экспериментам с разными задачами. В каждом из них людей случайно распределили на три группы. Одна работала без ИИ, другая с GPT-4, третья тоже с GPT-4, но сначала получила короткий обзор приёмов работы с запросами - обучающие видео и документы. Модель была одна для всех, GPT-4 в версии конца апреля 2023 года, на тот момент самая сильная. Работали с ней в чате на платформе компании.
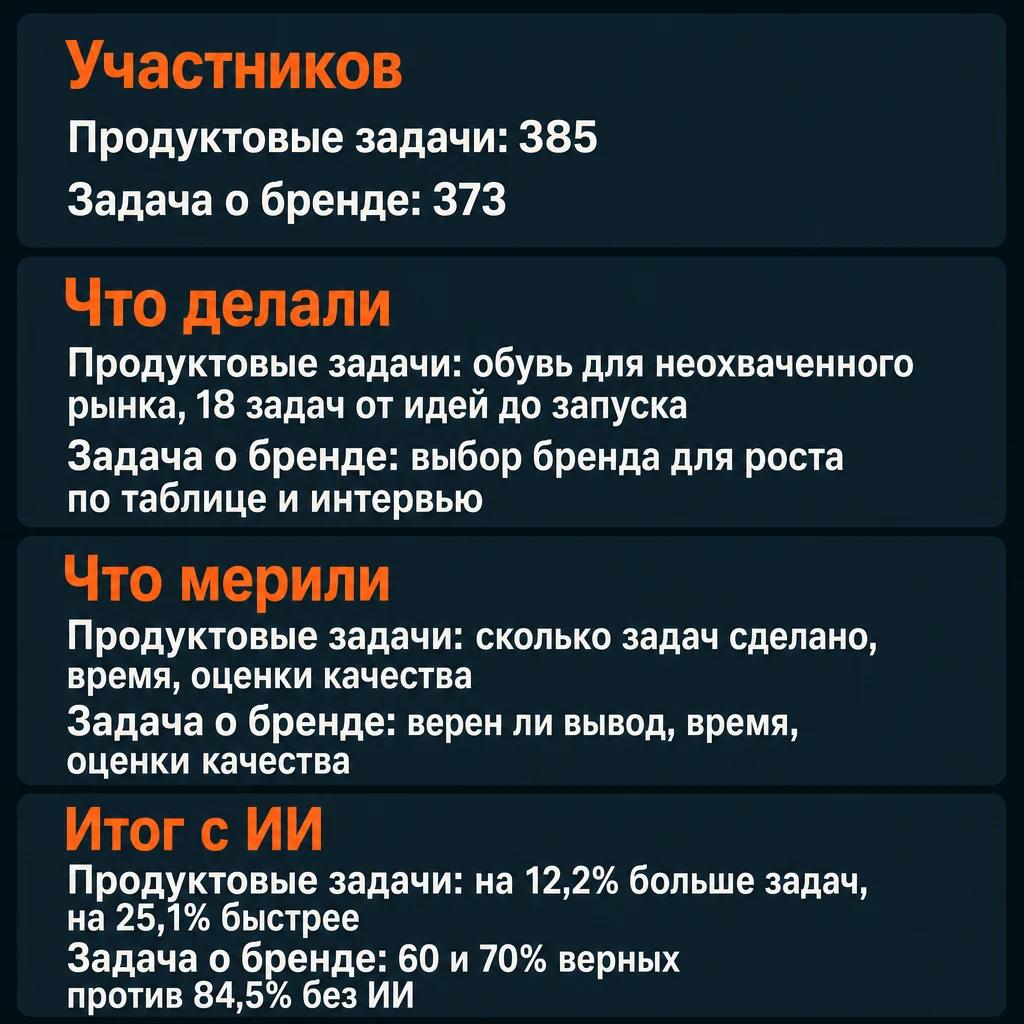
| Продуктовые задачи | Задача о бренде | |
|---|---|---|
| Участников | 385 | 373 |
| Что делали | обувь для неохваченного рынка, 18 задач от идей до запуска | выбор бренда для роста по таблице и интервью |
| Что мерили | сколько задач сделано, время, оценки качества | верен ли вывод, время, оценки качества |
| Итог с ИИ | на 12,2% больше задач, на 25,1% быстрее | 60 и 70% верных против 84,5% без ИИ |
Где модель ошибалась, ошибались и люди
Задача за границей возможностей модели в эксперименте была одна, и её подбирали так, чтобы GPT-4 в ней ошибался. По таблице с финансовыми данными и заметкам интервью с сотрудниками вымышленной компании консультанты выбирали, какой из её брендов развивать, и обосновывали выбор для генерального директора. Таблица выглядела полной, но решающие подробности были в интервью. С ними верный вывод получался другим - не тем, который давала модель, получив то же задание, таблицу и интервью.
Самим консультантам задача была по силам, без ИИ её решили верно больше восьми из десяти. С GPT-4 верных выводов стало в среднем на 19 процентных пунктов меньше. Группы собирали случайно, поэтому разница показывает влияние модели - часть консультантов, которые без неё пришли бы к верному выводу, с ней ошиблись.
При этом с ИИ задачу решали быстрее, на 18-30% в зависимости от группы, а их рекомендации оценщики ставили выше по качеству, причём и верные, и неверные. По выводу авторов, за границей возможностей модели люди слишком полагались на ИИ. Авторы из BCG добавляют, что многие участники приняли ошибочный вывод модели как есть, а в беседах многие называли её обоснование очень убедительным.
От ошибки не уберёг и короткий обзор. Он касался и приёмов запросов, и ограничений модели, но в группе, которая его получила, верных выводов было меньше всего - 60% против 70% у тех, кто работал с GPT-4 без обзора.
Кто с моделью ошибался реже
Позже часть авторов эксперимента разобрала переписку 244 консультантов с GPT-4 в задаче о бренде и выделила три способа работы. Больше половины оказались «киборгами». Они вели с моделью диалог на каждом шаге и часто просили её проверить собственный анализ и ответ. Примерно каждый седьмой был «кентавром». Такие консультанты держали ход анализа и вывод в своих руках, а модель брали для отдельных подзадач - собрать сведения или отшлифовать текст, который написали сами. Больше четверти переложили на модель и анализ, и оценку, причём почти половина из них сдала её ответ без правок.
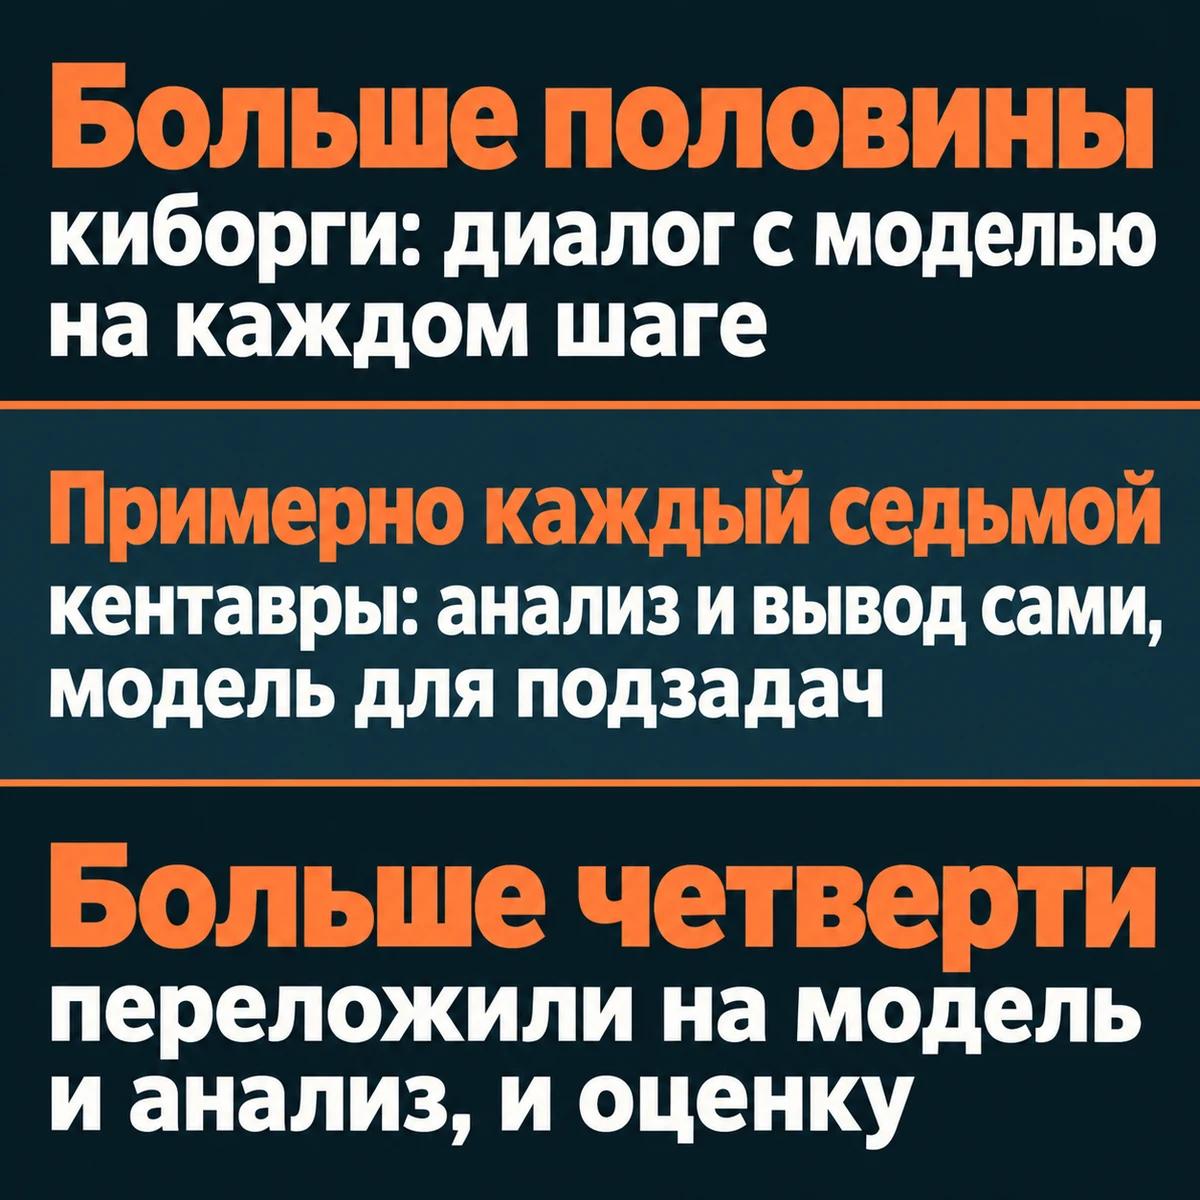
Реже всех ошибались «кентавры». Многих «киборгов» модель убедила в неверном ответе, хотя они просили её перепроверить себя. В примере авторов на просьбу проверить точность ответа модель подтвердила свой неверный вывод, и консультант его принял. Способ работы участникам не назначали, его выделили по переписке, поэтому разница в точности - наблюдение, а не доказанный рецепт.
Что сделать до того, как дать ИИ отделу
Цифры 2023 года - не прогноз для вашего отдела. Эксперимент шёл на консультантах одной компании и на модели GPT-4, вышедшей в марте 2023 года, а граница возможностей ИИ, как пишут авторы, расширяется и меняется. Переносится сам способ проверки. Авторы советуют разбирать каждую задачу в цепочке работы и для неё оценивать, какое сочетание людей и ИИ полезнее.
Допустим, аналитик по выгрузке из учётной системы готовит руководителю вывод, какое направление услуг развивать, а важная оговорка клиента записана только в протоколе встречи. Как и в задаче о бренде, решающая деталь здесь лежит вне основной таблицы, и такой случай можно проверить до того, как аналитик получит доступ к модели.
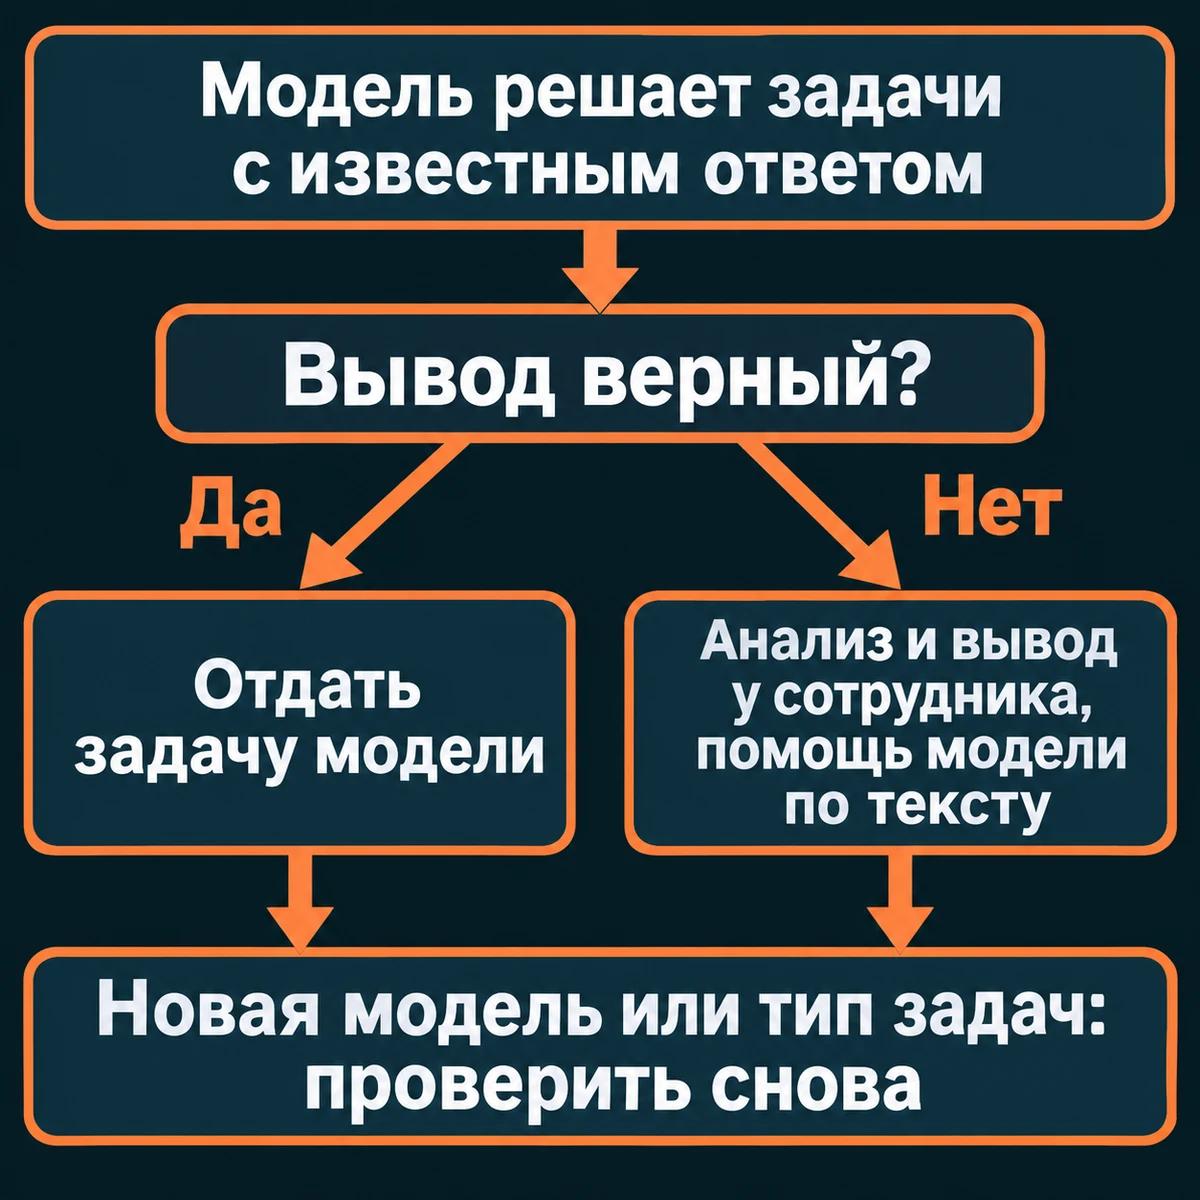
- Соберите задачи последних месяцев, верный ответ по которым уже известен, например по закрытому проекту, проверенному отчёту или решению, результат которого виден. Добавьте трудные случаи, где вывод зависит от детали вне основной таблицы - в переписке, протоколе или приложении.
- Дайте модели те же материалы, что были у сотрудника, и сравните её вывод с известным ответом, как при проверке задачи на десяти недавних случаях.
- Оценивайте вывод отдельно от формы. В эксперименте с ИИ росли баллы за качество и у неверных рекомендаций, так что по гладкости текста о верности вывода не судят. Как ловить такие ошибки при вычитке, разобрано на примере статей, которые писала нейросеть.
- Проверьте и сотрудника с моделью. Дайте задачу коллеге, который не знает ответа, и откройте ему доступ к модели. Модель может ошибиться, а сотрудник - поймать ошибку или пропустить её, и в эксперименте исход зависел от обоих. Ошибку ловят сверкой с исходными материалами, а не вопросом к модели, верен ли её ответ.
- Отдавайте модели задачи, на которых она давала верный вывод. В остальных её можно оставить помощником по тексту, а анализ и вывод - за сотрудником, как у кентавров.
- Повторяйте проверку при смене модели и при новом типе задач.
Для такой проверки подойдут обезличенные материалы. Клиентские данные и коммерческую тайну в публичную нейросеть не загружают. Что можно передавать внешнему сервису, решают с юристом и службой безопасности.
Если задача прошла проверку и повторяется каждый день, решать её вручную в чате не обязательно. ИИ-агент готовит по правилам компании сводку или черновик, сотрудник проверяет существенное, а критерии приёмки записывают ещё до запуска.
Кому поручать проверку подсказок модели и как заметить, что их принимают не глядя, рассказывает статья о бухгалтерах.
Источники
- Рабочая статья исследователей Гарвардской школы бизнеса и BCG, 22.09.2023
- Статья в журнале Organization Science, март 2026
- Рабочая статья Гарвардской школы бизнеса о трёх способах работы с моделью, декабрь 2025
- BCG о результатах эксперимента, 21.09.2023
- Технический отчёт о GPT-4, 15.03.2023